先按平台选择可用后端
ONNX 是模型交换格式,真正执行推理的是 ONNX Runtime 及其计算后端。选择硬件时不能只问“有没有显卡”,还要确认操作系统、驱动、运行时版本、模型算子和部署方式是否匹配。
| 平台 | 常用后端 | 更适合的情况 |
|---|---|---|
| Windows x64 | CPU、DirectML | 现有 Windows 工作站,使用 Intel、AMD 或 NVIDIA 图形设备 |
| Linux x86_64 | CPU、CUDA、OpenVINO | 服务器、独立分析主机、NVIDIA GPU 或 Intel CPU/GPU/NPU 环境 |
| Linux aarch64 | CPU | ARM 边缘设备和低通道部署,需单独验证实际处理速度 |
DirectML 的优势是覆盖 Windows 上多家 GPU,部署门槛相对低;CUDA 适合已经具备兼容 NVIDIA 驱动和运行库的 Linux 服务器;OpenVINO 适合 Intel 平台,并可根据设备情况使用 CPU、GPU 或 NPU。CPU 后端兼容性最好,也是判断模型和任务链路是否正确的基线。
为什么使用受控能力包
完整的 Analysis Node 安装包包含离线可用的基础视频分析能力,可直接完成画面巡检、人员车辆检测和常用时序规则。后续专项能力以官方签名能力包交付,包内同时固定模型、输入输出合同、类别标签、预处理、后处理、推荐阈值、来源和许可信息,避免出现“文件能加载但结果不可用”的情况。
联网环境由 StreamGate 从国内主源或镜像自动取得能力包,完成完整性和签名校验后一次下载、分发到选定节点;无网环境可导入 hbrun 提供的签名离线包。原始 ONNX 文件不能直接上传到生产节点,程序升级会保留已经验证和启用的能力包。
CUDA 和 OpenVINO 组件体积较大,可以作为独立的运行组件安装,但仍需经过版本和完整性校验。它们改变的是推理后端,不改变 StreamGate 的分析授权版本。
不能只看显卡利用率
视频分析的有效容量还受图像尺寸、抽帧间隔、模型耗时、CPU 解码、网络传输和任务类型影响。实际评估至少应记录平均和高分位处理耗时、队列长度、超时或回退状态,以及实时预览、录像是否受到影响。
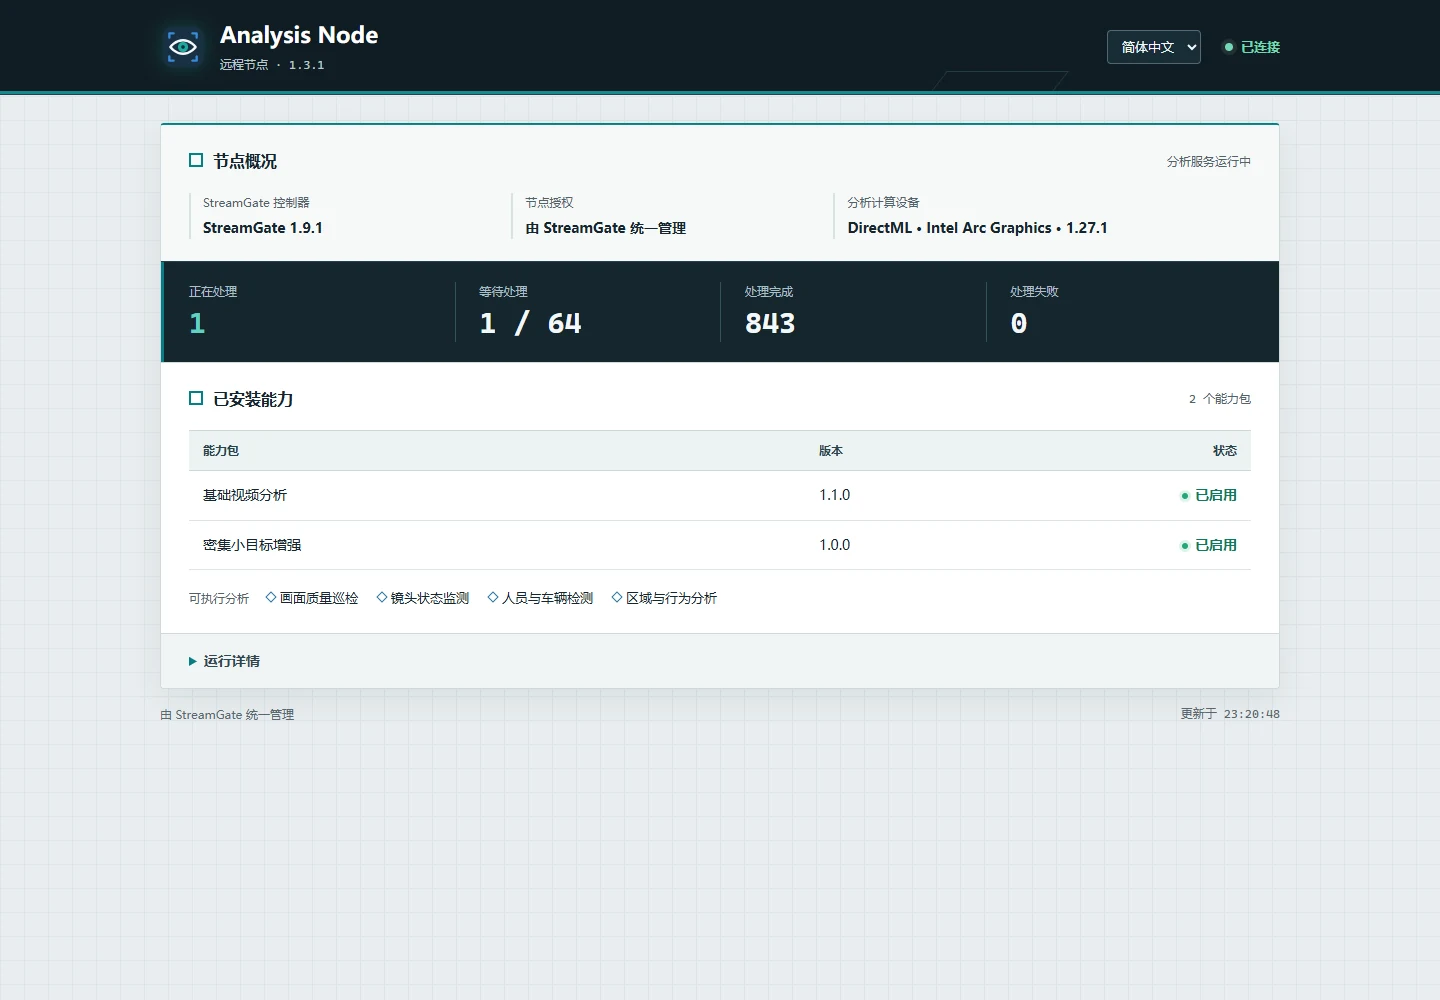
如果 GPU 后端初始化失败,系统应明确显示回退到 CPU 的原因,不能只显示“节点在线”。否则测试时看似可用,正式增加通道后才发现处理速度远低于预期。
硬件选型的稳妥流程
先在 CPU 后端用少量真实通道验证模型、区域和告警逻辑,再安装目标加速组件。然后逐步增加分析通道,观察单次处理耗时、队列和系统资源。远程节点还要测量图像传输和断线恢复。
对 Linux aarch64,可以通过交叉构建和 QEMU 验证程序与包的架构兼容性,但容量结论仍应以目标硬件实测为准。相同的 aarch64 架构可能使用完全不同的 CPU、内存带宽和加速能力,不能用一个设备的数字代表全部 ARM 平台。